

了解網站研究的運作方式
在你按下「開始研究」後會發生什麼事:雲端瀏覽器、五頁瀏覽限制、截圖與圖片、AI 如何為你的短片讀取所有內容、所需時間、它無法做到的事,以及你的研究結果如何被重複使用。
當你研究一個網站時,Clevera 會在其專屬雲端環境的瀏覽器中開啟該網站,由 AI 引導至你的短片所需的頁面,並讀取與拍攝它所顯示的一切。接著,第二個 AI 階段會將這些內容轉化為你的社群短片可以使用的資訊、圖片和影片。本文將說明每個階段,讓你了解預期結果並掌握操作方向。
若要開始研究,請參閱 研究網站以製作社群短片。
簡要說明
| 階段 | 發生事項 | 你在即時頁面上看到的內容 |
|---|---|---|
| 1. 開啟 | 一個全新的瀏覽器會在 Clevera 的雲端中開啟你的網址。 | 「正在開啟 acme.com…」 |
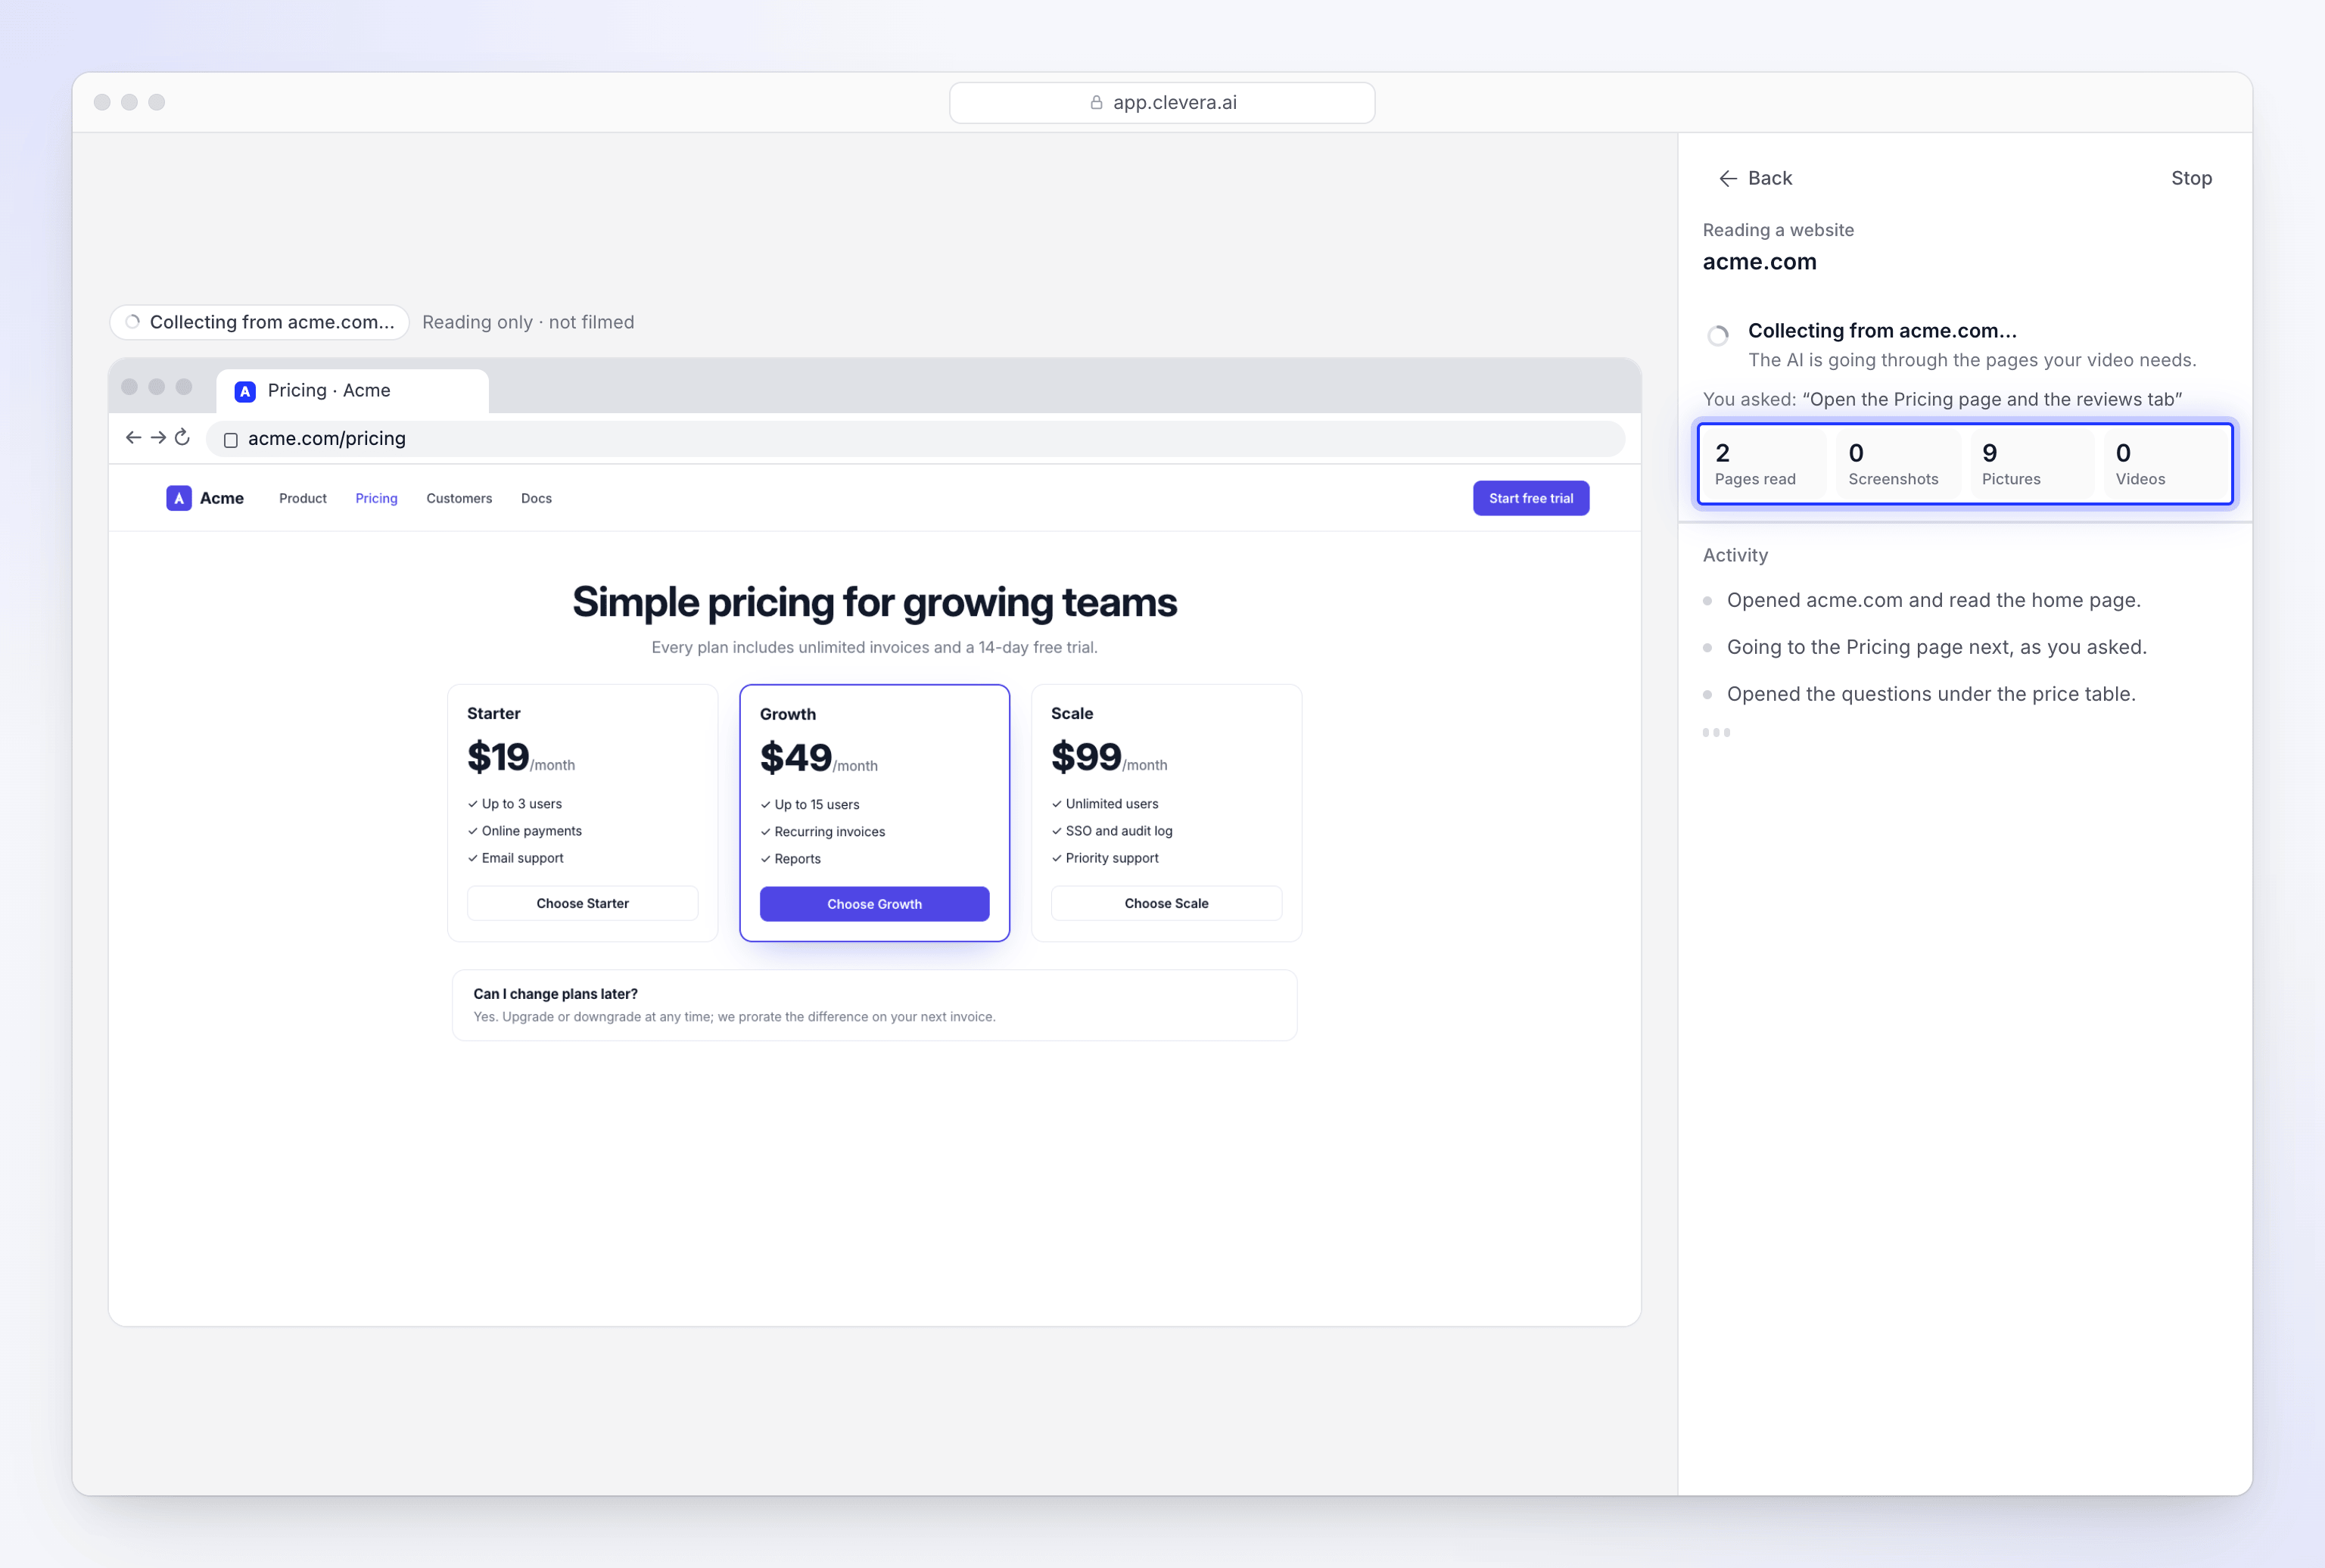
| 2. 瀏覽 | AI 會前往你筆記中指定的頁面,接著前往你的短片所需的頁面,並開啟分頁與摺疊選單。Clevera 會在瀏覽過程中讀取每一頁。 | 「正在從 acme.com 收集資料…」以及即時瀏覽器畫面 |
| 3. 拍攝 | Clevera 會重新造訪每個頁面以進行截圖、尋找標誌,並儲存圖片與影片。 | 「正在拍攝頁面圖片…」 |
| 4. 讀取 | AI 會在考量你的筆記與短片需求的情況下,讀取所有已收集的內容,並撰寫出相關事實。 | 「正在讀取已收集的內容…」 |
| 5. 完成 | 結果會儲存到你的工作區,且連結的圖塊會顯示「已收集」。 | 結果頁面 |
逐步說明
Clevera 檢查網址
在開啟任何內容之前,Clevera 會檢查該網址是否為公開的
https://頁面。本機網址、公司內部網路與純http://頁面將會被拒絕。它也會拒絕以下內容:- YouTube 網址,一律拒絕:「無法使用 YouTube 連結。如果影片是你自己的,請改為上傳檔案。」
- Clevera 不支援的網站:成人內容、賭博、停放或待售網域,以及不符合可接受使用規則的網站(會顯示「我們無法開啟此網站」及原因)。
- 公開網路釣魚清單上的網址。
- 不對外公開或不存在的頁面:回應「401 未經授權」、「404 找不到」或「410 已移除」的頁面。
- 完全沒有回應的網址(「我們無法連線至此網址。」)。僅僅是速度慢的網站不會被拒絕。
如果網址有重新導向,系統也會檢查導向後的頁面。此檢查會在任何付費工作開始前執行,因此被拒絕的網址不會產生費用。關於網站類型的拒絕訊息結尾會顯示「如果你認為這是錯誤,請透過 [email protected] 與我們聯絡。」請參閱 為什麼 Clevera 無法開啟連結。
以全新瀏覽器開啟網站
網站會在 Clevera 雲端的新瀏覽器中開啟,而非你的瀏覽器。它沒有歷史記錄、Cookie 或登入資訊,因此它看到的網站與初次造訪的使用者所見相同。
如果首頁是安全性檢查(「正在檢查你的瀏覽器…」)或網站拒絕造訪,Clevera 會嘗試在不同的連線環境下重新開始一次,並盡可能選擇符合該網站所在國家的連線。大多數網站都能在第一次嘗試時順利開啟。
AI 瀏覽你的短片所需的頁面
AI 知道你正在製作哪種類型的短片及其語言。它會依照下列順序處理網站內容:
- 優先處理你的筆記。 如果「我們應該查看什麼?」中指定了某個頁面、分頁、產品或區塊,AI 會優先前往該處。
- 接著是短片所需的內容,視網站類型而定。對於產品或軟體網站:功能或運作方式、定價、客戶或評論。對於商店:你詢問的產品及其圖庫、變體與評論。對於餐廳、地點或服務:他們提供的內容、菜單或價格,以及評論。
- 最多五個頁面,包含首頁在內。針對你所詢問內容的深度探討,優於對整個網站的瀏覽。
在每個頁面上,它會從上到下滾動一次,並開啟摺疊的內容:分頁、摺疊選單、常見問題項目、月費與年費切換開關、變體選擇器、圖庫以及「顯示更多」或「查看所有評論」按鈕。它會關閉 Cookie 橫幅、電子報彈出視窗與聊天氣泡,並在 Cookie 橫幅上選擇「拒絕」或「僅限必要」。
AI 本身不會記錄任何內容。它的工作是將正確的內容呈現在螢幕上。
Clevera 在瀏覽時讀取每一頁
當 AI 進行瀏覽時,Clevera 會直接從瀏覽器讀取每一頁:所有文字(包括開啟分頁或摺疊選單後顯示的文字)以及頁面上的圖片。你會看到即時頁面上的計數器增加:已讀頁面、截圖、圖片、影片。
Clevera 拍攝頁面
當 AI 完成工作後,Clevera 會在同一個瀏覽器中再次開啟它造訪過的每個頁面:
- 它會對每個頁面的頂部及其主要區塊進行截圖。
- 它會在首頁尋找你的標誌。
- 它會滾動頁面以載入延遲載入的圖片,並儲存產品圖片、照片與插圖。圖示、微小圖片、頭像以及頁首、導覽列或頁尾圖形將被排除。
- 它會下載網站本身託管的影片。嵌入自 YouTube 或 Vimeo 的影片不會被下載。
每個頁面也會經過檢查:這是真實的網站,還是安全性檢查、拒絕存取、登入頁面或空白頁面?只有真實頁面會被計入。安全性檢查頁面上的文字絕不會進入你的短片。
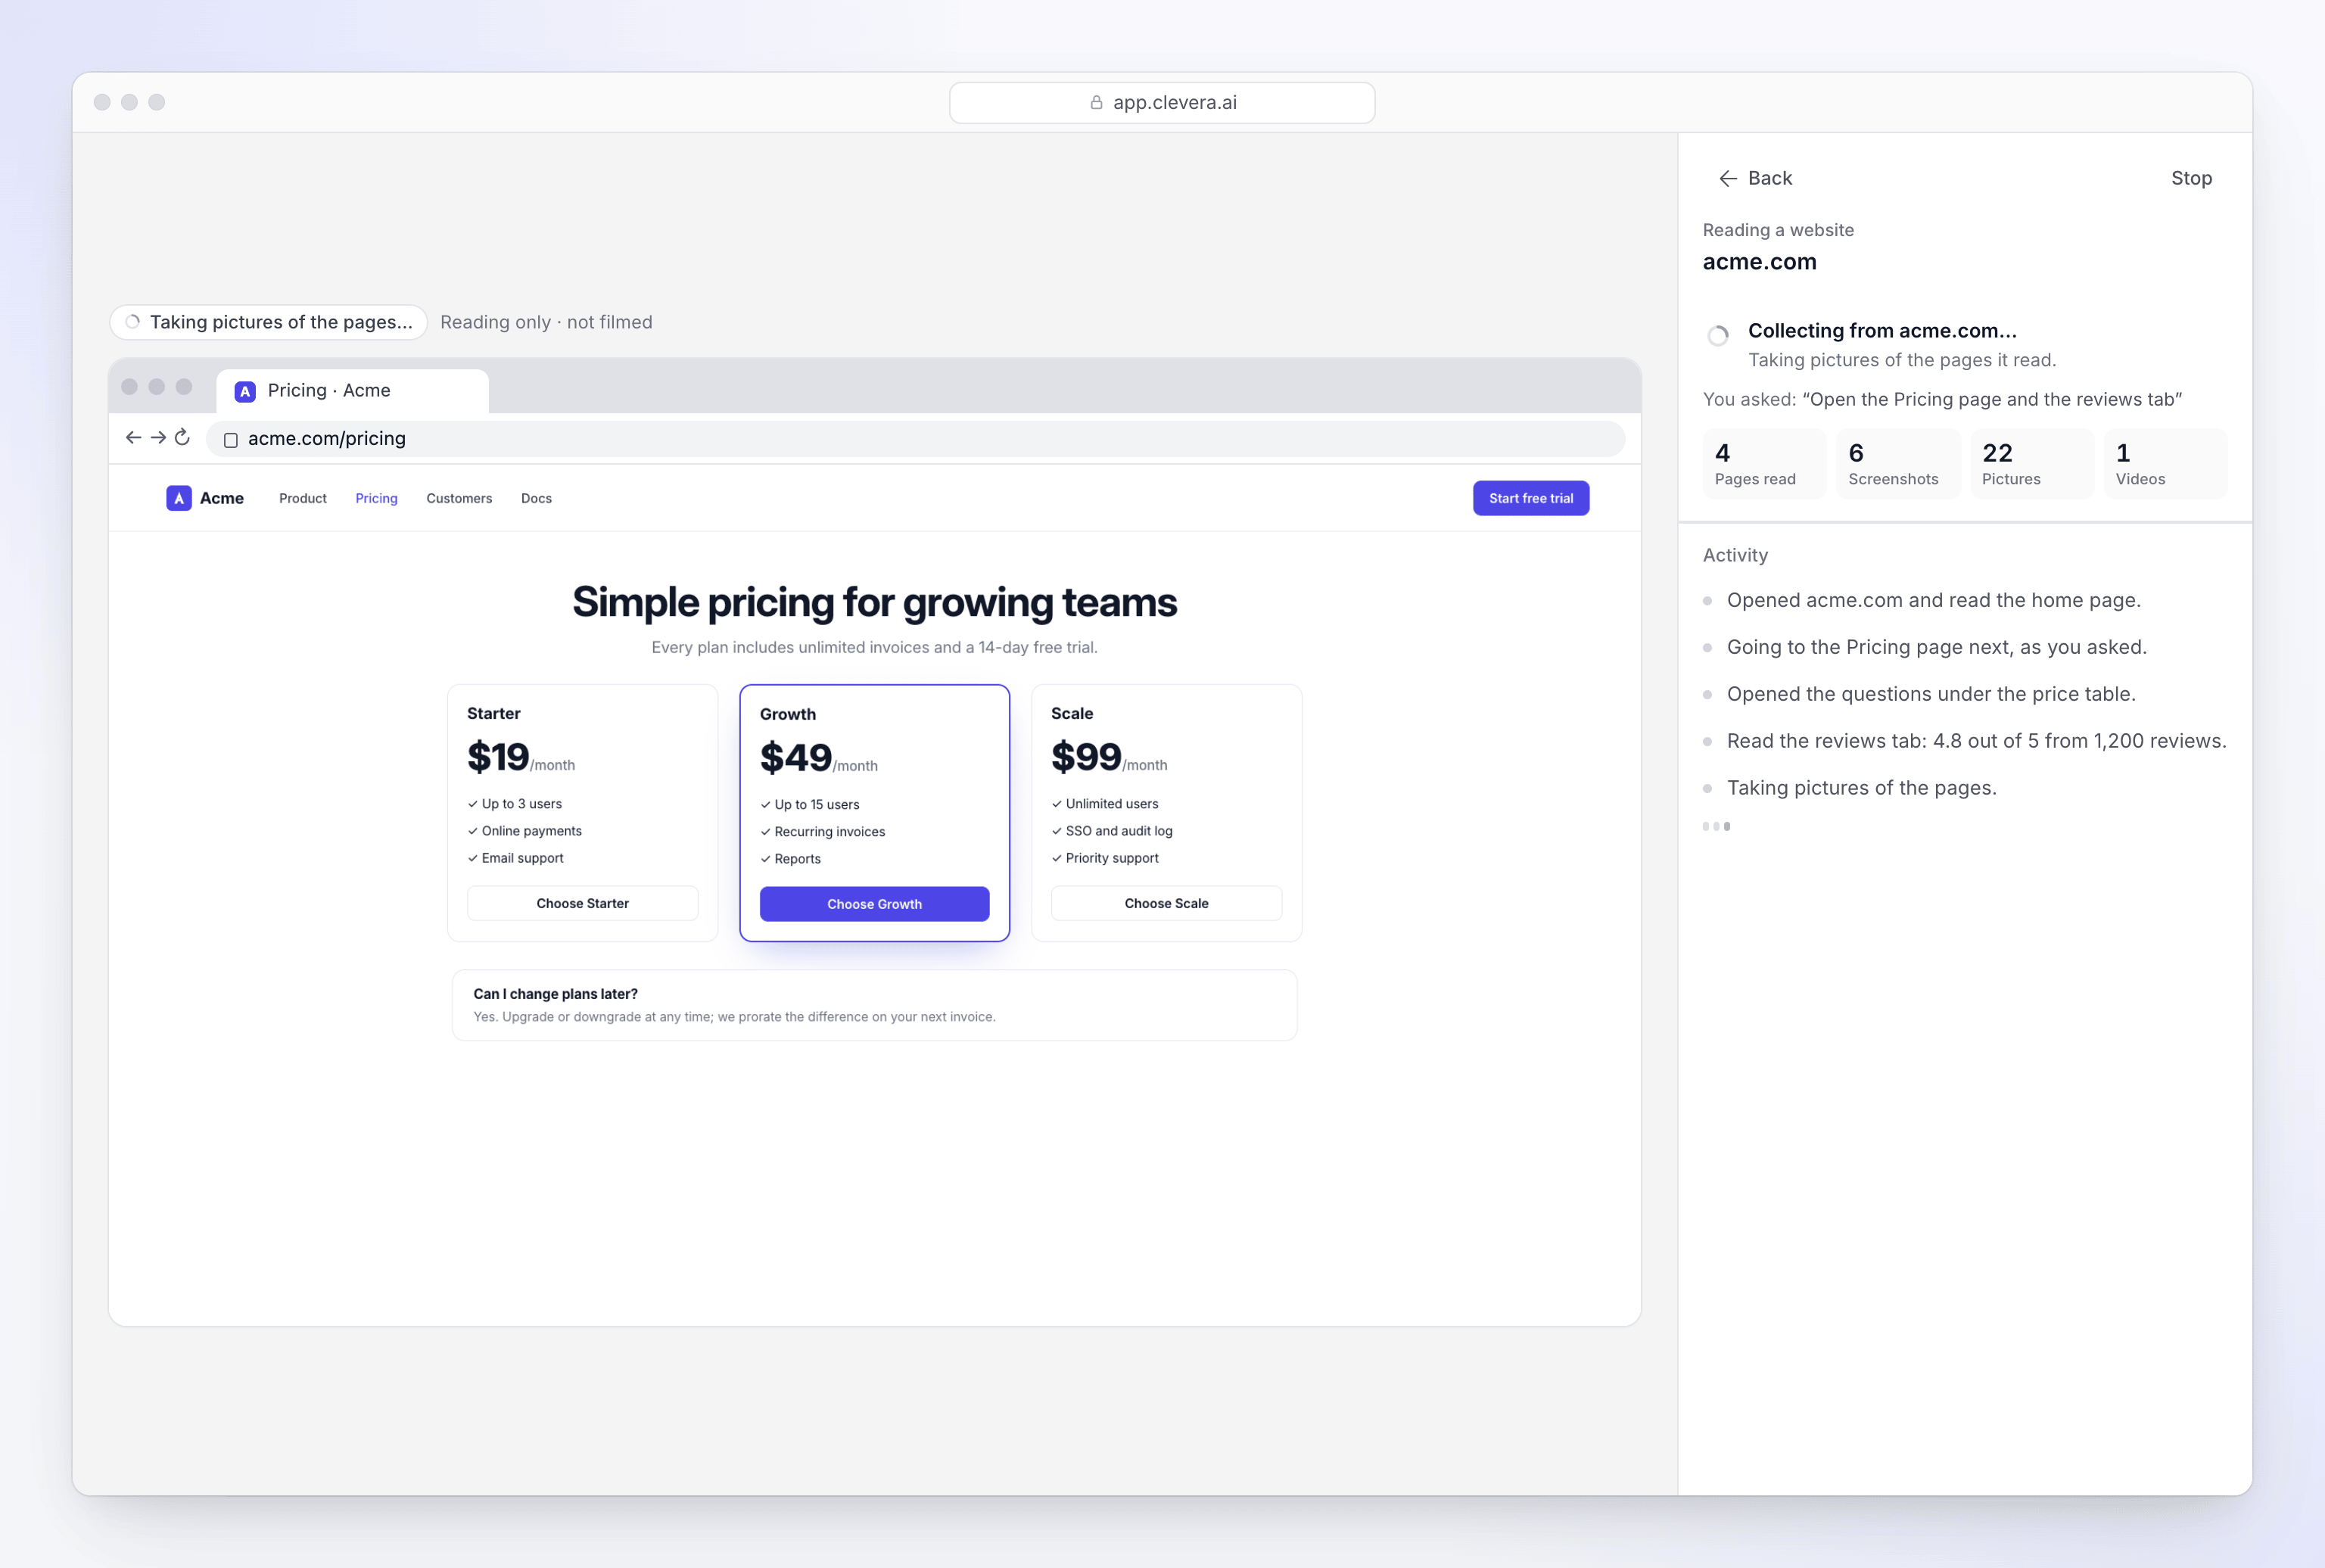
瀏覽完成後,Clevera 會重新造訪每個頁面以進行截圖與圖片擷取。 AI 讀取已收集的內容
造訪結束,圖塊顯示「正在讀取…」。現在,AI 會將頁面、截圖與圖片結合起來,並考量你的筆記與你正在製作的短片進行讀取。它會撰寫出:
- 網站內容:網站用途、目標客群、功能、證明(如評論或客戶數量)、優惠或定價,以及行動呼籲。
- 語氣與外觀:網站的語氣(附範例)及其視覺風格。
- 你要求的內容:針對你筆記中的每項要求,確認是否找到以及位於哪個頁面。
- 每張圖片的內容,以便 AI 導演能為每個場景選擇合適的圖片。
儲存結果
值得保留的圖片與影片會儲存到你的工作區媒體中,結果則會與該連結一併儲存。圖塊顯示「已收集」。當你進行產生時,AI 導演會根據這些事實與圖片製作你的短片。它不會再次造訪該網站。
所需時間
研究通常總共需要幾分鐘。對話框會顯示「需要幾分鐘」,在執行期間你可以繼續處理你的簡報。
| 階段 | 預估時間 |
|---|---|
| 瀏覽 | 最多約 4 分鐘。當 AI 取得所需內容後會提早停止。你指定的單一頁面大約需要一分鐘的工作時間。 |
| 拍攝 | 通常在 2 分鐘內。 |
| 讀取 | 通常需要一到兩分鐘。 |
你不必停留在該頁面上。你的草稿會被保留,且「產生影片」會等待連結準備就緒。
你在即時頁面上看到的內容
點擊連結圖塊上的「觀看」以開啟即時頁面。橫幅會顯示「我們正在為你讀取網站」。
- 瀏覽期間:即時瀏覽器、狀態列(如「正在從 acme.com 收集資料…」)、你在「你要求的內容:」下的筆記,以及計數器。
- 完成時:瀏覽器會被結果取代:事實、你要求的內容、截圖、圖片、標誌、影片與已讀頁面。點擊「返回編輯」即可返回。
- 如果無法讀取網站:會顯示原因、「再試一次」按鈕,以及「返回編輯後,你可以再次收集此連結、修改它或移除它。」
你可以觀看,但在研究期間無法接管瀏覽器或發送筆記。這是一項讀取工作,而非錄製。若要提早停止,請點擊「停止」,然後點擊「是」。
研究能做與不能做的事
| 能做 | 不能做 |
|---|---|
| 讀取單一網站及其子網域最多 5 個頁面 | 追蹤連結到其他網站 |
| 開啟分頁、摺疊選單、常見問題、價格切換開關與圖庫 | 登入、建立帳號或使用你儲存的登入資訊 |
| 關閉 Cookie 橫幅與彈出視窗 | 填寫或發送表單、加入購物車或結帳 |
| 等待大多數自動安全性檢查通過 | 解決所有安全性檢查:部分網站會封鎖自動化造訪 |
| 儲存網站託管的 MP4 與 WebM 影片 | 下載 YouTube 或 Vimeo 影片 |
| 讀取網頁 | 讀取 PDF 檔案。請改為將 PDF 上傳到你的短片 |
| 研究你自己的公開網站 | 讀取 YouTube 連結 |
如果網站無法讀取,請參閱 修正 AI 無法讀取的網站。
瀏覽時的安全性
- 頁面無法對 AI 下達指令。 頁面上的所有內容,包括彈出視窗、聊天訊息和隱藏文字,都會被視為需要閱讀的內容,絕不會被視為指令。
- 它絕不會輸入任何私人資訊。 研究功能不會輸入密碼、代碼或個人詳細資料,即使頁面要求,也絕不會登入。
- 它不會下載任何東西來執行。 它不會開啟或執行檔案、安裝任何東西,也不會授予頁面所要求的瀏覽器權限。
- 它絕不會涉及你的帳戶。 研究功能會使用一個沒有登入狀態的全新瀏覽器,絕不會使用你的瀏覽器或已儲存的登入資訊。
如何重複使用結果
| 情況 | 發生什麼事 |
|---|---|
| 你按下 開始研究 | 每次都是全新的造訪。 |
| 你選擇 上次研究 下的網站 | 重複使用其結果。不會有新的造訪,也不會產生新費用。 |
| 你將連結貼入簡報並生成 | Clevera 會重複使用工作區過去 7 天內對同一網站與同一筆記的閱讀內容。否則,它會在那時對該網站進行研究。 |
| 你更改了已收集連結上的筆記 | 已收集的內容保持不變。點擊 再次收集 以使用新筆記進行研究。 |
費用說明
研究功能沒有固定價格。它會根據 AI 閱讀的頁面與圖片數量,以及在網站上花費的時間來扣除點數,因此較大的網站會消耗更多點數。費用會加在你的短片預估費用之上。請參閱 了解網站研究與 AI 錄製的費用。